MATHHX A

MATHHX A

\(\newcommand{\footnotename}{footnote}\) \(\def \LWRfootnote {1}\) \(\newcommand {\footnote }[2][\LWRfootnote ]{{}^{\mathrm {#1}}}\) \(\newcommand {\footnotemark }[1][\LWRfootnote ]{{}^{\mathrm {#1}}}\) \(\let \LWRorighspace \hspace \) \(\renewcommand {\hspace }{\ifstar \LWRorighspace \LWRorighspace }\) \(\newcommand {\TextOrMath }[2]{#2}\) \(\newcommand {\mathnormal }[1]{{#1}}\) \(\newcommand \ensuremath [1]{#1}\) \(\newcommand {\LWRframebox }[2][]{\fbox {#2}} \newcommand {\framebox }[1][]{\LWRframebox } \) \(\newcommand {\setlength }[2]{}\) \(\newcommand {\addtolength }[2]{}\) \(\newcommand {\setcounter }[2]{}\) \(\newcommand {\addtocounter }[2]{}\) \(\newcommand {\arabic }[1]{}\) \(\newcommand {\number }[1]{}\) \(\newcommand {\noalign }[1]{\text {#1}\notag \\}\) \(\newcommand {\cline }[1]{}\) \(\newcommand {\directlua }[1]{\text {(directlua)}}\) \(\newcommand {\luatexdirectlua }[1]{\text {(directlua)}}\) \(\newcommand {\protect }{}\) \(\def \LWRabsorbnumber #1 {}\) \(\def \LWRabsorbquotenumber "#1 {}\) \(\newcommand {\LWRabsorboption }[1][]{}\) \(\newcommand {\LWRabsorbtwooptions }[1][]{\LWRabsorboption }\) \(\def \mathchar {\ifnextchar "\LWRabsorbquotenumber \LWRabsorbnumber }\) \(\def \mathcode #1={\mathchar }\) \(\let \delcode \mathcode \) \(\let \delimiter \mathchar \) \(\def \oe {\unicode {x0153}}\) \(\def \OE {\unicode {x0152}}\) \(\def \ae {\unicode {x00E6}}\) \(\def \AE {\unicode {x00C6}}\) \(\def \aa {\unicode {x00E5}}\) \(\def \AA {\unicode {x00C5}}\) \(\def \o {\unicode {x00F8}}\) \(\def \O {\unicode {x00D8}}\) \(\def \l {\unicode {x0142}}\) \(\def \L {\unicode {x0141}}\) \(\def \ss {\unicode {x00DF}}\) \(\def \SS {\unicode {x1E9E}}\) \(\def \dag {\unicode {x2020}}\) \(\def \ddag {\unicode {x2021}}\) \(\def \P {\unicode {x00B6}}\) \(\def \copyright {\unicode {x00A9}}\) \(\def \pounds {\unicode {x00A3}}\) \(\let \LWRref \ref \) \(\renewcommand {\ref }{\ifstar \LWRref \LWRref }\) \( \newcommand {\multicolumn }[3]{#3}\) \(\require {textcomp}\) \(\require {colortbl}\) \(\let \LWRorigcolumncolor \columncolor \) \(\renewcommand {\columncolor }[2][named]{\LWRorigcolumncolor [#1]{#2}\LWRabsorbtwooptions }\) \(\let \LWRorigrowcolor \rowcolor \) \(\renewcommand {\rowcolor }[2][named]{\LWRorigrowcolor [#1]{#2}\LWRabsorbtwooptions }\) \(\let \LWRorigcellcolor \cellcolor \) \(\renewcommand {\cellcolor }[2][named]{\LWRorigcellcolor [#1]{#2}\LWRabsorbtwooptions }\) \(\newcommand {\tothe }[1]{^{#1}}\) \(\newcommand {\raiseto }[2]{{#2}^{#1}}\) \(\newcommand {\LWRsiunitxEND }{}\) \(\def \LWRsiunitxang #1;#2;#3;#4\LWRsiunitxEND {\ifblank {#1}{}{\num {#1}\degree }\ifblank {#2}{}{\num {#2}^{\unicode {x2032}}}\ifblank {#3}{}{\num {#3}^{\unicode {x2033}}}}\) \(\newcommand {\ang }[2][]{\LWRsiunitxang #2;;;\LWRsiunitxEND }\) \(\def \LWRsiunitxdistribunit {}\) \(\newcommand {\LWRsiunitxENDTWO }{}\) \(\def \LWRsiunitxprintdecimalsubtwo #1,#2,#3\LWRsiunitxENDTWO {\ifblank {#1}{0}{\mathrm {#1}}\ifblank {#2}{}{{\LWRsiunitxdecimal }\mathrm {#2}}}\) \(\def \LWRsiunitxprintdecimalsub #1.#2.#3\LWRsiunitxEND {\LWRsiunitxprintdecimalsubtwo #1,,\LWRsiunitxENDTWO \ifblank {#2}{}{{\LWRsiunitxdecimal }\LWRsiunitxprintdecimalsubtwo #2,,\LWRsiunitxENDTWO }}\) \(\newcommand {\LWRsiunitxprintdecimal }[1]{\LWRsiunitxprintdecimalsub #1...\LWRsiunitxEND }\) \(\def \LWRsiunitxnumplus #1+#2+#3\LWRsiunitxEND {\ifblank {#2}{\LWRsiunitxprintdecimal {#1}}{\ifblank {#1}{\LWRsiunitxprintdecimal {#2}}{\LWRsiunitxprintdecimal {#1}\unicode {x02B}\LWRsiunitxprintdecimal {#2}}}\LWRsiunitxdistribunit }\) \(\def \LWRsiunitxnumminus #1-#2-#3\LWRsiunitxEND {\ifblank {#2}{\LWRsiunitxnumplus #1+++\LWRsiunitxEND }{\ifblank {#1}{}{\LWRsiunitxprintdecimal {#1}}\unicode {x02212}\LWRsiunitxprintdecimal {#2}\LWRsiunitxdistribunit }}\) \(\def \LWRsiunitxnumpmmacro #1\pm #2\pm #3\LWRsiunitxEND {\ifblank {#2}{\LWRsiunitxnumminus #1---\LWRsiunitxEND }{\LWRsiunitxprintdecimal {#1}\unicode {x0B1}\LWRsiunitxprintdecimal {#2}\LWRsiunitxdistribunit }}\) \(\def \LWRsiunitxnumpm #1+-#2+-#3\LWRsiunitxEND {\ifblank {#2}{\LWRsiunitxnumpmmacro #1\pm \pm \pm \LWRsiunitxEND }{\LWRsiunitxprintdecimal {#1}\unicode {x0B1}\LWRsiunitxprintdecimal {#2}\LWRsiunitxdistribunit }}\) \(\newcommand {\LWRsiunitxnumscientific }[2]{\ifblank {#1}{}{\ifstrequal {#1}{-}{-}{\LWRsiunitxprintdecimal {#1}\times }}10^{\LWRsiunitxprintdecimal {#2}}\LWRsiunitxdistribunit }\) \(\def \LWRsiunitxnumD #1D#2D#3\LWRsiunitxEND {\ifblank {#2}{\LWRsiunitxnumpm #1+-+-\LWRsiunitxEND }{\mathrm {\LWRsiunitxnumscientific {#1}{#2}}}}\) \(\def \LWRsiunitxnumd #1d#2d#3\LWRsiunitxEND {\ifblank {#2}{\LWRsiunitxnumD #1DDD\LWRsiunitxEND }{\mathrm {\LWRsiunitxnumscientific {#1}{#2}}}}\) \(\def \LWRsiunitxnumE #1E#2E#3\LWRsiunitxEND {\ifblank {#2}{\LWRsiunitxnumd #1ddd\LWRsiunitxEND }{\mathrm {\LWRsiunitxnumscientific {#1}{#2}}}}\) \(\def \LWRsiunitxnume #1e#2e#3\LWRsiunitxEND {\ifblank {#2}{\LWRsiunitxnumE #1EEE\LWRsiunitxEND }{\mathrm {\LWRsiunitxnumscientific {#1}{#2}}}}\) \(\def \LWRsiunitxnumx #1x#2x#3x#4\LWRsiunitxEND {\ifblank {#2}{\LWRsiunitxnume #1eee\LWRsiunitxEND }{\ifblank {#3}{\LWRsiunitxnume #1eee\LWRsiunitxEND \times \LWRsiunitxnume #2eee\LWRsiunitxEND }{\LWRsiunitxnume #1eee\LWRsiunitxEND \times \LWRsiunitxnume #2eee\LWRsiunitxEND \times \LWRsiunitxnume #3eee\LWRsiunitxEND }}}\) \(\newcommand {\num }[2][]{\LWRsiunitxnumx #2xxxxx\LWRsiunitxEND }\) \(\newcommand {\si }[2][]{\mathrm {\gsubstitute {#2}{~}{\,}}}\) \(\def \LWRsiunitxSIopt #1[#2]#3{\def \LWRsiunitxdistribunit {\,\si {#3}}{#2}\num {#1}\def \LWRsiunitxdistribunit {}}\) \(\newcommand {\LWRsiunitxSI }[2]{\def \LWRsiunitxdistribunit {\,\si {#2}}\num {#1}\def \LWRsiunitxdistribunit {}}\) \(\newcommand {\SI }[2][]{\ifnextchar [{\LWRsiunitxSIopt {#2}}{\LWRsiunitxSI {#2}}}\) \(\newcommand {\numlist }[2][]{\text {#2}}\) \(\newcommand {\numrange }[3][]{\num {#2}\ \LWRsiunitxrangephrase \ \num {#3}}\) \(\newcommand {\SIlist }[3][]{\text {#2}\,\si {#3}}\) \(\newcommand {\SIrange }[4][]{\num {#2}\,#4\ \LWRsiunitxrangephrase \ \num {#3}\,#4}\) \(\newcommand {\tablenum }[2][]{\mathrm {#2}}\) \(\newcommand {\ampere }{\mathrm {A}}\) \(\newcommand {\candela }{\mathrm {cd}}\) \(\newcommand {\kelvin }{\mathrm {K}}\) \(\newcommand {\kilogram }{\mathrm {kg}}\) \(\newcommand {\metre }{\mathrm {m}}\) \(\newcommand {\mole }{\mathrm {mol}}\) \(\newcommand {\second }{\mathrm {s}}\) \(\newcommand {\becquerel }{\mathrm {Bq}}\) \(\newcommand {\degreeCelsius }{\unicode {x2103}}\) \(\newcommand {\coulomb }{\mathrm {C}}\) \(\newcommand {\farad }{\mathrm {F}}\) \(\newcommand {\gray }{\mathrm {Gy}}\) \(\newcommand {\hertz }{\mathrm {Hz}}\) \(\newcommand {\henry }{\mathrm {H}}\) \(\newcommand {\joule }{\mathrm {J}}\) \(\newcommand {\katal }{\mathrm {kat}}\) \(\newcommand {\lumen }{\mathrm {lm}}\) \(\newcommand {\lux }{\mathrm {lx}}\) \(\newcommand {\newton }{\mathrm {N}}\) \(\newcommand {\ohm }{\mathrm {\Omega }}\) \(\newcommand {\pascal }{\mathrm {Pa}}\) \(\newcommand {\radian }{\mathrm {rad}}\) \(\newcommand {\siemens }{\mathrm {S}}\) \(\newcommand {\sievert }{\mathrm {Sv}}\) \(\newcommand {\steradian }{\mathrm {sr}}\) \(\newcommand {\tesla }{\mathrm {T}}\) \(\newcommand {\volt }{\mathrm {V}}\) \(\newcommand {\watt }{\mathrm {W}}\) \(\newcommand {\weber }{\mathrm {Wb}}\) \(\newcommand {\day }{\mathrm {d}}\) \(\newcommand {\degree }{\mathrm {^\circ }}\) \(\newcommand {\hectare }{\mathrm {ha}}\) \(\newcommand {\hour }{\mathrm {h}}\) \(\newcommand {\litre }{\mathrm {l}}\) \(\newcommand {\liter }{\mathrm {L}}\) \(\newcommand {\arcminute }{^\prime }\) \(\newcommand {\minute }{\mathrm {min}}\) \(\newcommand {\arcsecond }{^{\prime \prime }}\) \(\newcommand {\tonne }{\mathrm {t}}\) \(\newcommand {\astronomicalunit }{au}\) \(\newcommand {\atomicmassunit }{u}\) \(\newcommand {\bohr }{\mathit {a}_0}\) \(\newcommand {\clight }{\mathit {c}_0}\) \(\newcommand {\dalton }{\mathrm {D}_\mathrm {a}}\) \(\newcommand {\electronmass }{\mathit {m}_{\mathrm {e}}}\) \(\newcommand {\electronvolt }{\mathrm {eV}}\) \(\newcommand {\elementarycharge }{\mathit {e}}\) \(\newcommand {\hartree }{\mathit {E}_{\mathrm {h}}}\) \(\newcommand {\planckbar }{\mathit {\unicode {x210F}}}\) \(\newcommand {\angstrom }{\mathrm {\unicode {x212B}}}\) \(\let \LWRorigbar \bar \) \(\newcommand {\barn }{\mathrm {b}}\) \(\newcommand {\bel }{\mathrm {B}}\) \(\newcommand {\decibel }{\mathrm {dB}}\) \(\newcommand {\knot }{\mathrm {kn}}\) \(\newcommand {\mmHg }{\mathrm {mmHg}}\) \(\newcommand {\nauticalmile }{\mathrm {M}}\) \(\newcommand {\neper }{\mathrm {Np}}\) \(\newcommand {\yocto }{\mathrm {y}}\) \(\newcommand {\zepto }{\mathrm {z}}\) \(\newcommand {\atto }{\mathrm {a}}\) \(\newcommand {\femto }{\mathrm {f}}\) \(\newcommand {\pico }{\mathrm {p}}\) \(\newcommand {\nano }{\mathrm {n}}\) \(\newcommand {\micro }{\mathrm {\unicode {x00B5}}}\) \(\newcommand {\milli }{\mathrm {m}}\) \(\newcommand {\centi }{\mathrm {c}}\) \(\newcommand {\deci }{\mathrm {d}}\) \(\newcommand {\deca }{\mathrm {da}}\) \(\newcommand {\hecto }{\mathrm {h}}\) \(\newcommand {\kilo }{\mathrm {k}}\) \(\newcommand {\mega }{\mathrm {M}}\) \(\newcommand {\giga }{\mathrm {G}}\) \(\newcommand {\tera }{\mathrm {T}}\) \(\newcommand {\peta }{\mathrm {P}}\) \(\newcommand {\exa }{\mathrm {E}}\) \(\newcommand {\zetta }{\mathrm {Z}}\) \(\newcommand {\yotta }{\mathrm {Y}}\) \(\newcommand {\percent }{\mathrm {\%}}\) \(\newcommand {\meter }{\mathrm {m}}\) \(\newcommand {\metre }{\mathrm {m}}\) \(\newcommand {\gram }{\mathrm {g}}\) \(\newcommand {\kg }{\kilo \gram }\) \(\newcommand {\of }[1]{_{\mathrm {#1}}}\) \(\newcommand {\squared }{^2}\) \(\newcommand {\square }[1]{\mathrm {#1}^2}\) \(\newcommand {\cubed }{^3}\) \(\newcommand {\cubic }[1]{\mathrm {#1}^3}\) \(\newcommand {\per }{\,\mathrm {/}}\) \(\newcommand {\celsius }{\unicode {x2103}}\) \(\newcommand {\fg }{\femto \gram }\) \(\newcommand {\pg }{\pico \gram }\) \(\newcommand {\ng }{\nano \gram }\) \(\newcommand {\ug }{\micro \gram }\) \(\newcommand {\mg }{\milli \gram }\) \(\newcommand {\g }{\gram }\) \(\newcommand {\kg }{\kilo \gram }\) \(\newcommand {\amu }{\mathrm {u}}\) \(\newcommand {\nm }{\nano \metre }\) \(\newcommand {\um }{\micro \metre }\) \(\newcommand {\mm }{\milli \metre }\) \(\newcommand {\cm }{\centi \metre }\) \(\newcommand {\dm }{\deci \metre }\) \(\newcommand {\m }{\metre }\) \(\newcommand {\km }{\kilo \metre }\) \(\newcommand {\as }{\atto \second }\) \(\newcommand {\fs }{\femto \second }\) \(\newcommand {\ps }{\pico \second }\) \(\newcommand {\ns }{\nano \second }\) \(\newcommand {\us }{\micro \second }\) \(\newcommand {\ms }{\milli \second }\) \(\newcommand {\s }{\second }\) \(\newcommand {\fmol }{\femto \mol }\) \(\newcommand {\pmol }{\pico \mol }\) \(\newcommand {\nmol }{\nano \mol }\) \(\newcommand {\umol }{\micro \mol }\) \(\newcommand {\mmol }{\milli \mol }\) \(\newcommand {\mol }{\mol }\) \(\newcommand {\kmol }{\kilo \mol }\) \(\newcommand {\pA }{\pico \ampere }\) \(\newcommand {\nA }{\nano \ampere }\) \(\newcommand {\uA }{\micro \ampere }\) \(\newcommand {\mA }{\milli \ampere }\) \(\newcommand {\A }{\ampere }\) \(\newcommand {\kA }{\kilo \ampere }\) \(\newcommand {\ul }{\micro \litre }\) \(\newcommand {\ml }{\milli \litre }\) \(\newcommand {\l }{\litre }\) \(\newcommand {\hl }{\hecto \litre }\) \(\newcommand {\uL }{\micro \liter }\) \(\newcommand {\mL }{\milli \liter }\) \(\newcommand {\L }{\liter }\) \(\newcommand {\hL }{\hecto \liter }\) \(\newcommand {\mHz }{\milli \hertz }\) \(\newcommand {\Hz }{\hertz }\) \(\newcommand {\kHz }{\kilo \hertz }\) \(\newcommand {\MHz }{\mega \hertz }\) \(\newcommand {\GHz }{\giga \hertz }\) \(\newcommand {\THz }{\tera \hertz }\) \(\newcommand {\mN }{\milli \newton }\) \(\newcommand {\N }{\newton }\) \(\newcommand {\kN }{\kilo \newton }\) \(\newcommand {\MN }{\mega \newton }\) \(\newcommand {\Pa }{\pascal }\) \(\newcommand {\kPa }{\kilo \pascal }\) \(\newcommand {\MPa }{\mega \pascal }\) \(\newcommand {\GPa }{\giga \pascal }\) \(\newcommand {\mohm }{\milli \ohm }\) \(\newcommand {\kohm }{\kilo \ohm }\) \(\newcommand {\Mohm }{\mega \ohm }\) \(\newcommand {\pV }{\pico \volt }\) \(\newcommand {\nV }{\nano \volt }\) \(\newcommand {\uV }{\micro \volt }\) \(\newcommand {\mV }{\milli \volt }\) \(\newcommand {\V }{\volt }\) \(\newcommand {\kV }{\kilo \volt }\) \(\newcommand {\W }{\watt }\) \(\newcommand {\uW }{\micro \watt }\) \(\newcommand {\mW }{\milli \watt }\) \(\newcommand {\kW }{\kilo \watt }\) \(\newcommand {\MW }{\mega \watt }\) \(\newcommand {\GW }{\giga \watt }\) \(\newcommand {\J }{\joule }\) \(\newcommand {\uJ }{\micro \joule }\) \(\newcommand {\mJ }{\milli \joule }\) \(\newcommand {\kJ }{\kilo \joule }\) \(\newcommand {\eV }{\electronvolt }\) \(\newcommand {\meV }{\milli \electronvolt }\) \(\newcommand {\keV }{\kilo \electronvolt }\) \(\newcommand {\MeV }{\mega \electronvolt }\) \(\newcommand {\GeV }{\giga \electronvolt }\) \(\newcommand {\TeV }{\tera \electronvolt }\) \(\newcommand {\kWh }{\kilo \watt \hour }\) \(\newcommand {\F }{\farad }\) \(\newcommand {\fF }{\femto \farad }\) \(\newcommand {\pF }{\pico \farad }\) \(\newcommand {\K }{\mathrm {K}}\) \(\newcommand {\dB }{\mathrm {dB}}\) \(\newcommand {\kibi }{\mathrm {Ki}}\) \(\newcommand {\mebi }{\mathrm {Mi}}\) \(\newcommand {\gibi }{\mathrm {Gi}}\) \(\newcommand {\tebi }{\mathrm {Ti}}\) \(\newcommand {\pebi }{\mathrm {Pi}}\) \(\newcommand {\exbi }{\mathrm {Ei}}\) \(\newcommand {\zebi }{\mathrm {Zi}}\) \(\newcommand {\yobi }{\mathrm {Yi}}\) \(\let \unit \si \) \(\let \qty \SI \) \(\let \qtylist \SIlist \) \(\let \qtyrange \SIrange \) \(\let \numproduct \num \) \(\let \qtyproduct \SI \) \(\let \complexnum \num \) \(\newcommand {\complexqty }[3][]{(\complexnum {#2})\si {#3}}\) \(\newcommand {\mleft }{\left }\) \(\newcommand {\mright }{\right }\) \(\newcommand {\mleftright }{}\) \(\newcommand {\mleftrightrestore }{}\) \(\require {gensymb}\) \(\newcommand {\intertext }[1]{\text {#1}\notag \\}\) \(\let \Hat \hat \) \(\let \Check \check \) \(\let \Tilde \tilde \) \(\let \Acute \acute \) \(\let \Grave \grave \) \(\let \Dot \dot \) \(\let \Ddot \ddot \) \(\let \Breve \breve \) \(\let \Bar \bar \) \(\let \Vec \vec \) \(\require {cancel}\) \(\newcommand {\mathred }[1]{\textcolor [rgb]{1, 0, 0}{#1}}\) \(\newcommand {\mathgreen }[1]{\textcolor [rgb]{0,0.5,0}{#1}}\) \(\newcommand {\mathblue }[1]{\textcolor [rgb]{0,0,1}{#1}}\) \(\newcommand {\mathorange }[1]{\textcolor [rgb]{1,0.5,0}{#1}}\) \(\newcommand {\mathmagenta }[1]{\textcolor [cmyk]{0, 1, 1, 0.33}{#1}}\) \( \newcommand \ccancel [2][red]{\renewcommand \CancelColor {\color {#1}}\cancel {#2}} \) \(\newcommand {\Dom }{\operatorname {Dom}}\) \(\newcommand {\Ran }{\operatorname {Ran}}\) \(\newcommand {\Dm }{\operatorname {Dm}}\) \(\newcommand {\Vm }{\operatorname {Vm}}\) \(\newcommand {\Var }{\operatorname {Var}}\) \(\newcommand {\SD }{\operatorname {SD}}\) \(\newcommand {\ExV }{\operatorname {E}}\) \(\newcommand {\opointtext }{\textcolor {blue}{\circ }}\) \(\newcommand {\cpointtext }{\textcolor {blue}{\bullet }}\) \(\newcommand {\vectwo }[2]{\begin {pmatrix} #1 \\ #2 \end {pmatrix}}\) \(\newcommand {\tcbset }[1]{}\) \(\newcommand {\tcbsetforeverylayer }[1]{}\) \(\newcommand {\tcbox }[2][]{\boxed {\text {#2}}}\) \(\newcommand {\tcboxfit }[2][]{\boxed {#2}}\) \(\newcommand {\tcblower }{}\) \(\newcommand {\tcbline }{}\) \(\newcommand {\tcbtitle }{}\) \(\newcommand {\tcbsubtitle [2][]{\mathrm {#2}}}\) \(\newcommand {\tcboxmath }[2][]{\boxed {#2}}\) \(\newcommand {\tcbhighmath }[2][]{\boxed {#2}}\) \(\newcommand {\toprule }[1][]{\hline }\) \(\let \midrule \toprule \) \(\let \bottomrule \toprule \) \(\def \LWRbooktabscmidruleparen (#1)#2{}\) \(\newcommand {\LWRbooktabscmidrulenoparen }[1]{}\) \(\newcommand {\cmidrule }[1][]{\ifnextchar (\LWRbooktabscmidruleparen \LWRbooktabscmidrulenoparen }\) \(\newcommand {\morecmidrules }{}\) \(\newcommand {\specialrule }[3]{\hline }\) \(\newcommand {\addlinespace }[1][]{}\) \(\def \LWRsiunitxrangephrase {\TextOrMath { }{\ }\protect \mbox {to (numerical range)}\TextOrMath { }{\ }}\) \(\def \LWRsiunitxdecimal {.}\)

5.9 Konfidensintervaller for normalfordelinger (A)

På b-niveau lærte vi at bestemme konfidensintervaller for sandsynlighedsparameteren i en binomialfordeling. I dette afsnit skal vi se, hvordan man bestemmer konfidensintervaller for middelværdien i en normalfordeling.

Vi vender tilbage til vores æbleplantage fra b-niveau (afsnit om konfidensintervaller for binomialfordelingen). Denne gang er vi interesserede i gennemsnitsvægten af æblerne i plantagen. Vi antager, at æblernes vægt kan beskrives med en normalfordelt stokastisk variabel:

\[ X\sim N(\mu ,\sigma ) \]

hvor parametrene \(\mu \) og \(\sigma \) er ukendte. Vi ønsker at estimere middelværdien \(\mu \) ud fra en stikprøve. Vi udtager derfor en stikprøve og regner gennemsnitsvægten \(\overline {x}\). Antag, at gennemsnitsvægten målt i gram er:

\[ \overline {x}=107 \]

Gennemsnitsvægten kan bruges som et estimat for gennemsnitsvægten i populationen (samtlige æbler), og dermed har vi vores estimat som vi betegner med \(\hat {\mu }\). Vi har altså, at

\[ \hat {\mu }=\overline {x}=107 \]

Ønsker vi at udtale os om usikkerheden på estimatet, kan vi angive et konfidensinterval for middelværdien, præcis tilsvarende til det vi gjorde, da vi bestemte konfidensintervaller for \(p\) i en binomialfordeling. I modsætning til situationen med binomialfordelingen, hvor der kun var én ukendt parameter (\(p\)) er der nu to ukendte parametre \(\mu \) og \(\sigma \), og vi skal også bruge et estimat af \(\sigma \), før vi kan bestemme konfidensintervallet. Det gøres ved først at regne et estimat af variansen:

\[ s^2 = \frac {\sum _{i=1}^{n} (x_i-\overline {x})^2}{n-1}\]

hvor \(n\) er stikprøvestørrelsen. Denne formel er anderledes end den formel vi tidligere har set for varians:

\[ \sigma ^2 = \frac {\sum _{i=1}^{n} (x_i-\overline {x})^2}{n}\]

hvor vi dividerer med populationens størrelse \(n\) i stedet for \(n-1\). Så når man skal regne varians, er der altså to forskellige formler, som ikke giver det samme. Skal man regne et estimat af populationens varians ud fra en stikprøve, bruger man første formel, men har man hele populationen, skal man bruge den anden. Her på hhx vil vi som regel være i den første situation. Vi husker, at man finder standardafvigelsen ved at tage kvadratroden af variansen, og et estimat af standardafvigelsen \(\hat {\sigma }\) kan dermed bestemmes med formlen:

\[ \hat {\sigma }=s=\sqrt { \frac {\sum _{i=1}^{n} (x_i-\overline {x})^2}{n-1}}\]

Formlen for \(s\) er bygget ind i Excel og bruges med kommandoen:

\[ \verb |STDAFV.S| \]

  • Eksempel 5.9.1
    Antag, at vi har en stikprøve fra en normalfordelt population. Stikprøven består af tallene: \(14,15,19\)

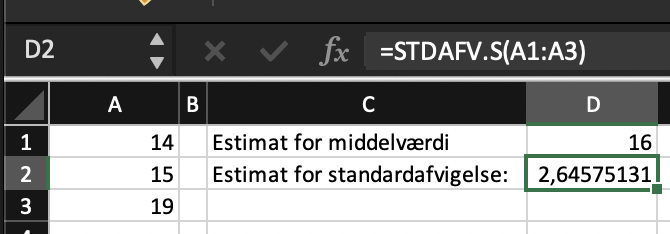
    Vi vil regne estimater for populationens middelværdi og standardafvigelse i Excel. Vi bestemmer \(\hat {\mu }\) ved at bestemme gennemsnittet \(\overline {x}\) med kommandoen MIDDEL og \(\hat {\sigma }\) ved at bestemme \(s\) med kommandoen \(\verb |STDAFV.S|\) som vist i screenshottet:

    (image)

    Vi har altså estimaterne \(\hat {\mu }=16\) og \(\hat {\sigma }=2{,}65\).

Øvelse 5.9.1

Antag, at vi har en stikprøve fra en population. Stikprøven består af tallene: \(1, 5, 7, 11\)

Bestem følgende estimater:

  • a) Middelværdien ved hjælp af Excel.

  • b) Standardafvigelsen ved hjælp af Excel.

  • c) Middelværdien ved beregning.

  • d) Standardafvigelse ved beregning.

 5.9.1

  • a) \(\hat {\mu }=6\)

  • b) \(\hat {\sigma }=4{,}16\)

  • c) \(\hat {\mu }=6\)

  • d) \(\hat {\sigma }=4{,}16\)

Selve konfidensintervallet bestemmes ved brug af følgende formel:

  • Sætning 5.9.1
    Lad \(X\sim N(\mu ,\sigma )\). Hvis standardafvigelsen er ukendt, bestemmes et konfidensinterval \(C_{1-\alpha }\) for \(\mu \) ved formlen:

    \[ C_{1-\alpha }=\left [\bar {x}-t_{1-\frac {\alpha }{2}}\cdot \frac {s}{\sqrt {n}};\bar {x}+t_{1-\frac {\alpha }{2}}\cdot \frac {s}{\sqrt {n}}\right ] \]

    Her er:

    .
    \(n\) Stikprøvens størrelse
    \(\bar {x}\) Gennemsnittet af stikprøven
    \(s\) Estimat af populations standardafvigelse
    \(\alpha \) Signifikansniveauet som decimaltal
    \(t_{1-\frac {\alpha }{2}}\) \(\left (1-\frac {\alpha }{2}\right )\)-fraktilen i \(t\)-fordeling med \(n-1\) frihedsgrader.

Læg mærke til, at formlen tager udgangspunkt i, at standardafvigelsen er ukendt. Sådan vil det næsten altid være i praksis – man har kun rå data og intet andet.

  • Eksempel 5.9.2
    Vi vil bruge ovenstående formel til at bestemme et \(95\%\)-konfidensinterval for middelværdien af populationen fra eksempel 5.9.1. I eksemplet fandt vi estimaterne \(\hat {\mu }=\overline {x}=16\) og \(\hat {\sigma }=2{,}65\). Vi finder først \(\alpha \):

    \begin{align*} \alpha & = 1 - \text {konfidensniveauet}\\ & = 1 - 0{,}95\\ & = 0{,}05 \end{align*} Så bestemmes antallet af frihedsgrader \(k\) ud fra stikprøvestørrelsen \(n=3\):

    \[ k=n-1=3-1=2 \]

    Vi bestemmer nu \(t_{1-\frac {0{,}05}{2}}=t_{0{,}975}\) for \(k=2\) som forklaret i sidste afsnit. Den giver:

    \[ t_{0{,}975} = 4{,}3027 \]

    Vi har nu, hvad vi skal bruge for at regne konfidensintervallet.

    \begin{align*} C_{1-\alpha } & = \left [\bar {x}-t_{1-\frac {\alpha }{2}}\cdot \frac {s}{\sqrt {n}};\bar {x}+t_{1-\frac {\alpha }{2}}\cdot \frac {s}{\sqrt {n}}\right ] \\ & = \left [16-4{,}3027\cdot \frac {2{,}65}{\sqrt {3}};16+4{,}3027\cdot \frac {2{,}65}{\sqrt {3}}\right ]\\ & = [9{,}4; 22{,}6] \end{align*} Konfidensintervallet er altså: \([9{,}4; 22{,}6]\). Det var et meget bredt interval, men stikprøvestørrelsen er også minimal, må man sige.

I eksemplet fandt vi \(95\%\)-konfidensintervallet \([9{,}4; 22{,}6]\). Det betyder, at vi kan være \(95\%\) sikre på, at middelværdien for populationen ligger i dette interval. Så vores bedste bud på middelværdien for populationen er \(16\), men det er et usikkert estimat. Skal vi udtale os med større sikkerhed, må vi begrænse os til at sige, at middelværdien ligger i intervallet \([9{,}4; 22{,}6]\). Det kan vi til gengæld være \(95\%\) sikre på er rigtigt.

Øvelse 5.9.2

Antag, at vi har en stikprøve fra en normalfordelt population bestående af observationerne: \(-5,0,1,7\).

  • a) Brug formlen til at bestemme et \(95\%\)-konfidensinterval for populationens middelværdi.

  • b) Forklar betydningen af det fundne interval.

 5.9.2

  • a) \([-7{,}1;8{,}6]\)

  • b) Vi kan med \(95\%\) sikkerhed sige, at middelværdien for populationen ligger i intervallet \([-7{,}1;8{,}6]\).

Konfidensintervaller i GeoGebra

Det er lidt besværligt at bruge formlen, så vi vil som regel bruge GeoGebra til at bestemme konfidensintervaller.

  • Eksempel 5.9.3
    Vi vil bestemme et \(95\%\)-konfidensinterval for middelværdien af populationen fra eksempel 5.9.1 ved hjælp af GeoGebra. Vi husker, at vi i eksemplet fandt, at \(\hat {\mu }=16\) og \(\hat {\sigma }=2{,}65\) for en stikprøve med \(3\) observationer.

    GeoGebra skal bruge tre værdier for at regne konfidensintervallet:

    .
    Middel Estimat for middelværdien. I vores tilfælde: \(16\)
    s Estimat for standardafvigelsen. I vores tilfælde \(2{,}65\)
    n Antallet af observationer i stikprøven. I vores tilfælde: \(3\)

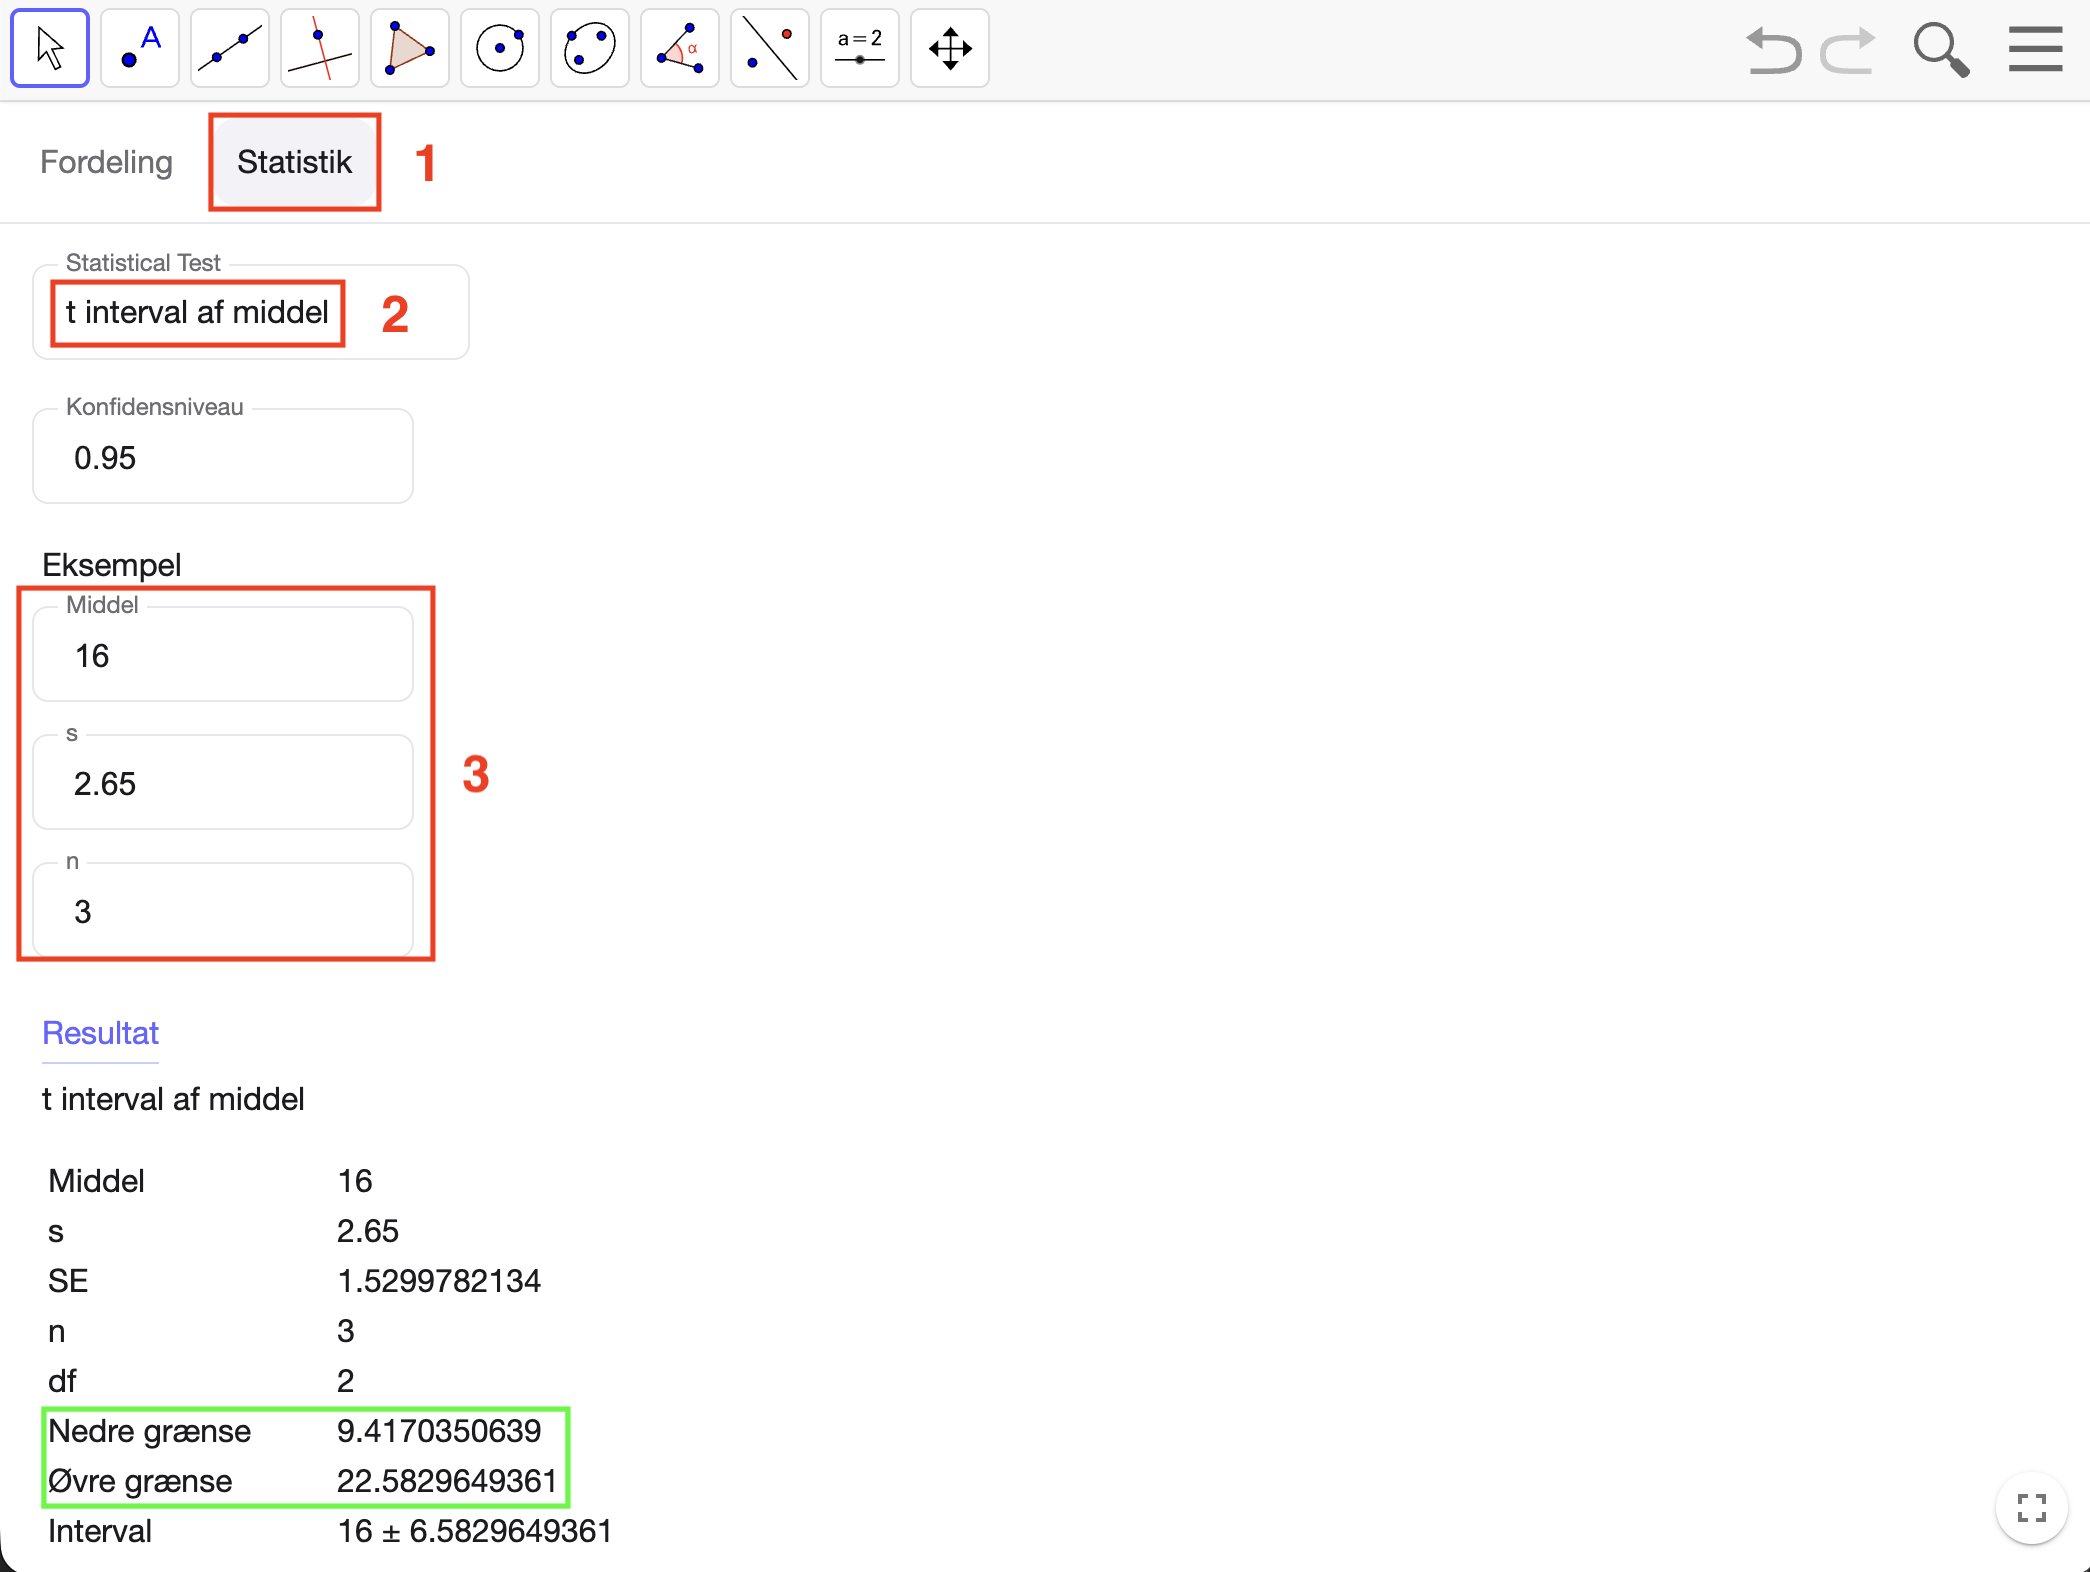
    Vi åbner sandsynlighedslommeregneren, vælger ”Statistik”, ”t-interval af middel” og taster de tre værdier. Det giver os:

    (image)

    Konfidensintervallet er det lukkede interval mellem den nedre og øvre grænse markeret i screenshottet. Altså intervallet \([9{,}4; 22{,}6]\), hvilket passer med det, vi beregnede tidligere, hurra!

Øvelse 5.9.3

Forestil dig, at du nu vil købe endnu en æbleplantage til dit frugtimperium, men du vil gerne have en plantage med store æbler. Du køber derfor 10 æbler fra en udvalgt plantage, som du vejer enkeltvis. Du får disse resultater. Vi antager, at vægten af æblerne er normalfordelt.

  • a) Bestem et estimat for middelværdien af vægten af æblerne i plantagen.

  • b) Bestem et \(95\%\)-konfidensinterval for middelværdien.

  • c) Du vil kun købe plantagen, hvis du kan være sikker på, at middelværdien af æblernes vægt er over 100. Vurder, om du bør købe plantagen.

 5.9.3

  • a) \(104\)

  • b) \([92;116]\)

  • c) Konfidensintervallet indeholder værdier, som er under \(100\). Det betyder, at du ikke med rimelig sikkerhed kan vide, at middelværdien er over \(100\). Så du kan desværre ikke købe plantagen. Trist.

Konfidensintervaller når standardafvigelsen er kendt

Selvom det er sjældent, at vi er i en situation, hvor populationens standardafvigelse er kendt og middelværdien ukendt, så skal vi alligevel se på en formel for konfidensintervallet i den situation.

  • Sætning 5.9.2
    Hvis standardafvigelsen er kendt, bestemmes et konfidensinterval \(I\) for middelværdien i en normalfordeling ved formlen:

    \[C_{1-\alpha }=\left [\bar {x}-z_{1-\frac {\alpha }{2}}\cdot \frac {\sigma }{\sqrt {n}};\bar {x}+z_{1-\frac {\alpha }{2}}\cdot \frac {\sigma }{\sqrt {n}}\right ]\]

    Her er:

    .
    \(n\): Stikprøvens størrelse
    \(\bar {x}\): Gennemsnittet af stikprøven
    \(\sigma \): Populationens standardafvigelse
    \(\alpha \): Signifikansniveauet som decimaltal
    \(z_{1-\frac {\alpha }{2}}\): \(\left (1-\frac {\alpha }{2}\right )\)-fraktilen i standardnormalfordelingen.

I denne formel er fraktilerne fra standardnormalfordelingen i stedet for fra t-fordelinger. Det gør formlen nemmere at bruge, da der kun er én standardnormalfordeling, og vi dermed kan lave en tabel med de mest almindelige fraktiler:

\(\begin {array}{| l | l |} \hline \alpha & z_{1-\frac {\alpha }{2}} \\ \hline 1\% & 2,576 \\ 5\% & 1,960\\ 10\% & 1,645\\ \hline \end {array}\)

Tabel 5.1: Fraktiler i standardnormalfordelingen.

Ovenstående tabel indeholder de værdier, du allerede har bestemt i et tidligere afsnit. Nu tænker du måske: ”Er det ikke ligemeget, at formlen er nem at bruge, hvis vi aldrig er i en situation, hvor vi kan bruge den?”. Det spørgsmål vil du få svar på, når du regner følgende øvelse:

Øvelse 5.9.4 ()

Vi har set, at når vi har et højt antal frihedsgrader, ligner t-fordelingen standardnormalfordelingen. Brug dette til at argumentere for:

  • a) Hvis stikprøven er meget stor, kan vi bruge formlen for kendt standardafvigelse selvom vi ikke kender standardafvigelsen.

  • b) At dette ikke er så overraskende.

 5.9.4

  • a) Den eneste forskel i formlerne er fraktilerne, og når stikprøvestørrelsen (og dermed antallet af frihedsgrader) er stor, så ligner \(t\)-fordelingen standardnormalfordelingen, og vi får derfor samme værdi for fraktilerne, uanset om vi bruger t-fordeling eller standardnormalfordeling. Så de to formler giver samme resultat.

  • b) Det er ikke overraskende, da vi vil forvente at estimatet af standardafvigelsen vil ligge tæt på populationens standardafvigelse, hvis stikprøven er stor. Derfor vil ”fejlen”, ved at anvende et estimat i stedet for den rigtige værdi, være minimal.

  • Eksempel 5.9.4
    Vi vil bestemme et \(95\%\)-konfidensinterval for en stikprøve med kendt standardafvigelse. Stikprøven har en størrelse på \(200\), et gennemsnit på \(1000\) og populationens standardafvigelse er \(30\). Vi har altså:

    \(n = 200\)
    \(\bar {x} = 1000\)
    \(\sigma = 30\)
    \(\alpha = 0{,}05\)

    Vi slår \(z_{1-\frac {\alpha }{2}}\) op i tabel 5.1, og får den til \(1{,}96\).

    Vi skal nu sætte ind i formlen

    \[I=\left [\bar {x}-z_{1-\frac {\alpha }{2}}\cdot \frac {\sigma }{\sqrt {n}};\bar {x}+z_{1-\frac {\alpha }{2}}\cdot \frac {\sigma }{\sqrt {n}}\right ]\]

    så det gør vi og får

    \[I=\left [1000-1{,}960\cdot \frac {30}{\sqrt {200}};1000+1{,}960\cdot \frac {30}{\sqrt {200}}\right ]\]

    Vi taster hele pivetøjet ind på en lommeregner og får:

    \[I=[996;1004]\]

Øvelse 5.9.5

Vi ser på en stikprøve fra en normalfordelt population. Vi har \(500\) observationer, som har et gennemsnit på \(20\). Populationens standardafvigelse er \(5\).

  • a) Bestem ved beregning et \(90\%\)-konfidensinterval for middelværdien. Du må gerne bruge GeoGebra som lommeregner, men ikke til andet.

 5.9.5

  • a) \([19{,}6;20{,}4]\)

Når populationen ikke er normalfordelt

Overskriften på dette afsnit er konfidensintervaller for normalfordelingen. Men formlerne i afsnittet kan faktisk anvendes mere generelt også. Har vi en stor stikprøve (tommelfingerregel: en stikprøvestørrelse på minimum 30), så virker metoden også for andre typer af fordelinger (forklaring i ekstraafsnit). Typisk er stikprøvestørrelserne større end 30, så generelt vil vi ikke bekymre os om, hvorvidt populationen er normalfordelt eller ej. Det vil sige, at metoderne i afsnittet kan bruges til at bestemme konfidensintervaller for middelværdier uanset hvordan data er fordelt, så længe stikprøvestørrelsen er stor.

Ekstra

I dette ekstraafsnit skal vi se på to interessante ting. Først vil vi se på, hvorfor der skal en ny formel i spil, når vi estimerer variansen ud fra en stikprøve, og bagefter vil vi se på, hvorfor man kan bruge formler for konfidensintervaller for normalfordelingen på noget, som ikke er normalfordelt.

Hvorfor særlig formel for variansestimatet?

Man kan undre sig over, hvad der er galt med at bruge stikprøvens egen standardafvigelse som estimat for populationens. Er stikprøven meget stor, er stikprøvens egen standardafvigelse da også et fint estimat for populationens standardafvigelse, men jo mindre stikprøven er, jo mere problematisk bliver dette estimat. Årsagen er, at standardafvigelsen er bestemt ud fra variansen, og formlen for variansen indeholder middelværdien. Når vi ikke har middelværdien, er vi nødt til at benytte et estimat af middelværdien og man kan vise, at når man benytter estimatet for middelværdien i stedet for den rigtige middelværdi, får man altid en standardafvigelse, som er for lille. Man kan vise, at man kan kompensere for den ”fejl” ved at dividere med \(n-1\) i stedet for \(n\) i formlen for varians.

Øvelse 5.9.6

I eksempel 5.9.1 fandt vi estimaterne \(\hat {\mu }=16\) og \(\hat {\sigma }=2{,}65\) for en stikprøve bestående af tallene: \(14,15,19\).

  • a) Regn ved hjælp af en formel et estimat af populationens standardafvigelse.

  • b) Regn nu ved hjælp af en formel stikprøvens egen standardafvigelse.

  • c) Sammenlign de to. Er alt som forventet?

 5.9.6

  • a) \(\hat {\sigma }=2{,}65\)

  • b) \(\sigma =2{,}16\)

  • c) Vi ser, at estimatet for standardafvigelsen er større end stikprøvens egen standardafvigelse. Det er helt som forventet jf. ovenstående forklaringer. Det er en meget lille stikprøve, og derfor er der også relativ stor forskel mellem de to.

Hvorfor kan man bruge formlerne på data, der ikke er normalfordelt?

Vi husker den centrale grænseværdisætning:

  • Sætning 5.7.1 (Den centrale grænseværdisætning)
    Lad \(X_1,X_2,\ldots X_n\) være uafhængige, ensfordelte stokastiske variable med endelig middelværdi og varians. Da er den stokastiske variabel

    \[ X=\sum _{i=1}^{n} X_i \]

    tilnærmelsesvist normalfordelt når \(n\) er stor.

Vi regner gennemsnittet med formlen

\[ \overline {x} =\frac {\sum _{i=1}^{n} x_i}{n} \]

Her kan tælleren opfattes som en værdi for en stokastisk variabel, der er en sum af ensfordelte uafhængige stokastiske variable. Ifølge den centrale grænseværdisætning vil denne stokastiske variabel være tilnærmelsesvis normalfordelt, når \(n\) er stor. Så vi har altså en tilnærmelsesvis normalfordelt stokastisk variabel divideret med \(n\). Man kan vise, at hvis man dividerer en normalfordelt stokastisk variabel med et tal, så er resultatet stadig normalfordelt, og derfor er \(\overline {x}\) tilnærmelsesvis normalfordelt.